DÉCOUVERTE DE MODÈLES D’IA
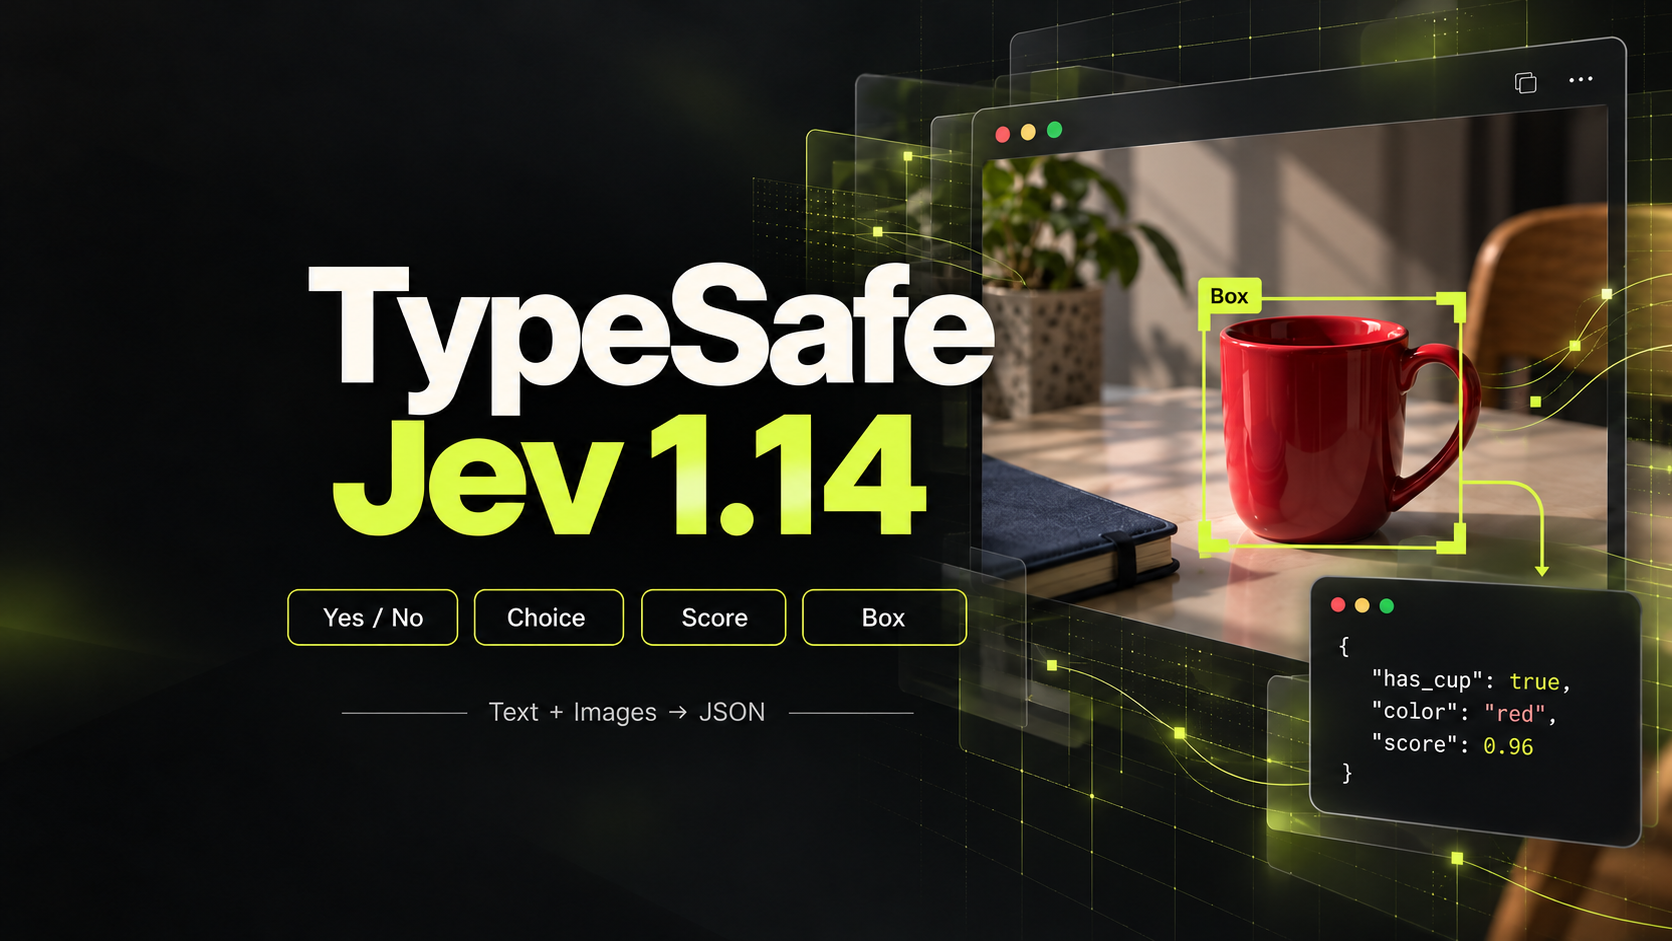
 TypeSafe
 Jev 1.14
Structured multimodal decisions from text, JSON, and inline images.
Trouvez une API Texte vers vidéo pour votre prochaine scène
FOURNISSEURS
 Black Forest Labs
 Kling
 Lightricks
 OpenAI
 Runway
 SeeAPI
 Vidu








Chronologie des sorties de modèles
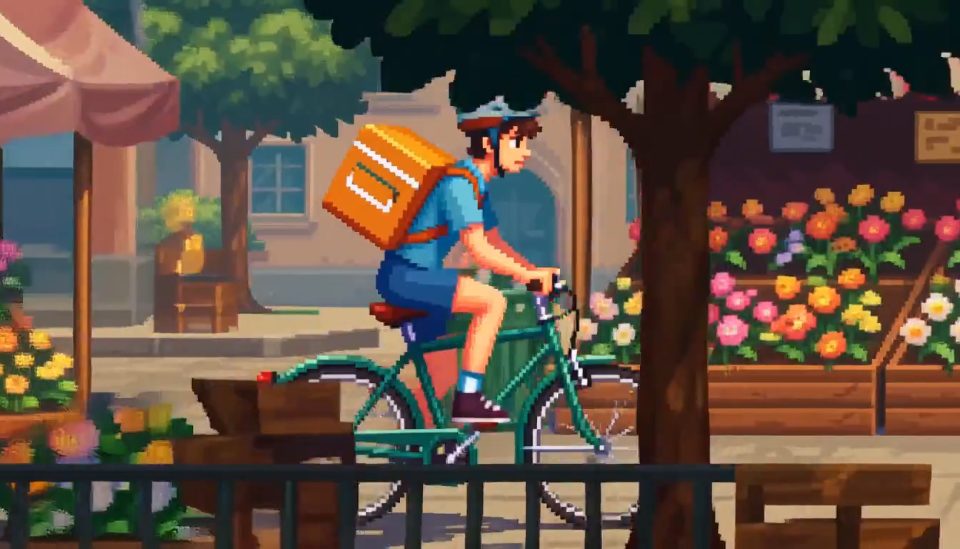
MiniMax H3 Max 16-bit Pixel
MiniMaxCréez des vidéos pixel art 16 bits avec audio en 768P de 5 à 15 secondes à partir de texte ou d’une image initiale.
Wan 3.0 Prime
AlibabaGénération vidéo Alibaba Wan 3.0 Prime avec références de texte, d'image, de vidéo, d'audio, de document et de page web.
Wan 3.0
AlibabaGénération vidéo Alibaba Wan 3.0 avec références de texte, d'image, de vidéo, d'audio, de document et de page web.
MiniMax H3 Max Turbo
MiniMaxGénérez des vidéos de 5 à 15 secondes à partir de texte ou d’images en 480P, 768P ou 1080P.
Gemini Omni Flash 1.1
GoogleGemini Omni Flash 1.1 video generation with image, video, audio, and character references.
Seedance 2.5
ByteDanceModèle vidéo nouvelle génération de ByteDance pour les récits longs, avec jusqu'à 50 références multimodales
MiniMax H3
MiniMaxGénération vidéo multimodale avec audio natif via MiniMax H3 (Hailuo 03), jusqu’en 2K.
Seedance 2.0 Mini
ByteDanceModèle vidéo Seedance 2.0 économique de ByteDance, conçu pour une génération plus rapide et des coûts d'inférence réduits
Seedance 2.0 Fast
ByteDanceVidéo multimodale rapide et abordable avec entrées texte, image, vidéo et audio jusqu'à 720p
HappyHorse 1.1
AlibabaHappyHorse 1.1 prend en charge le texte vers vidéo, l’image vers vidéo et la référence vers vidéo avec davantage de formats d’image.
Transformez une scène écrite en brief exploitable
Une API Texte vers vidéo produit une séquence animée à partir d’une description.
Décrivez une action précise
Indiquez le sujet, l’action, le décor et le cadrage.
Comparez le même livrable
Conservez l’intention du prompt, tout en adaptant la requête à chaque contrat.
Décidez si le son est nécessaire
Pour des dialogues, une ambiance ou des effets, consultez Vidéo avec audio.
Du brief de scène à la requête API
Présélectionnez les capacités avant de construire un flux vidéo plus large.
Rédigez un plan complet
Séparez les exigences indispensables des choix de style facultatifs.
Lisez l’endpoint choisi
Vérifiez les champs de requête, les sorties admises et la récupération des tâches.
Évaluez avant d’étendre
Testez dans votre intégration autorisée et examinez la séquence entière.
API Texte vers vidéo : questions fréquentes
Les points à clarifier avant une première intégration.
Son entrée principale est un prompt décrivant une scène en mouvement.