DÉCOUVERTE DE MODÈLES D’IA
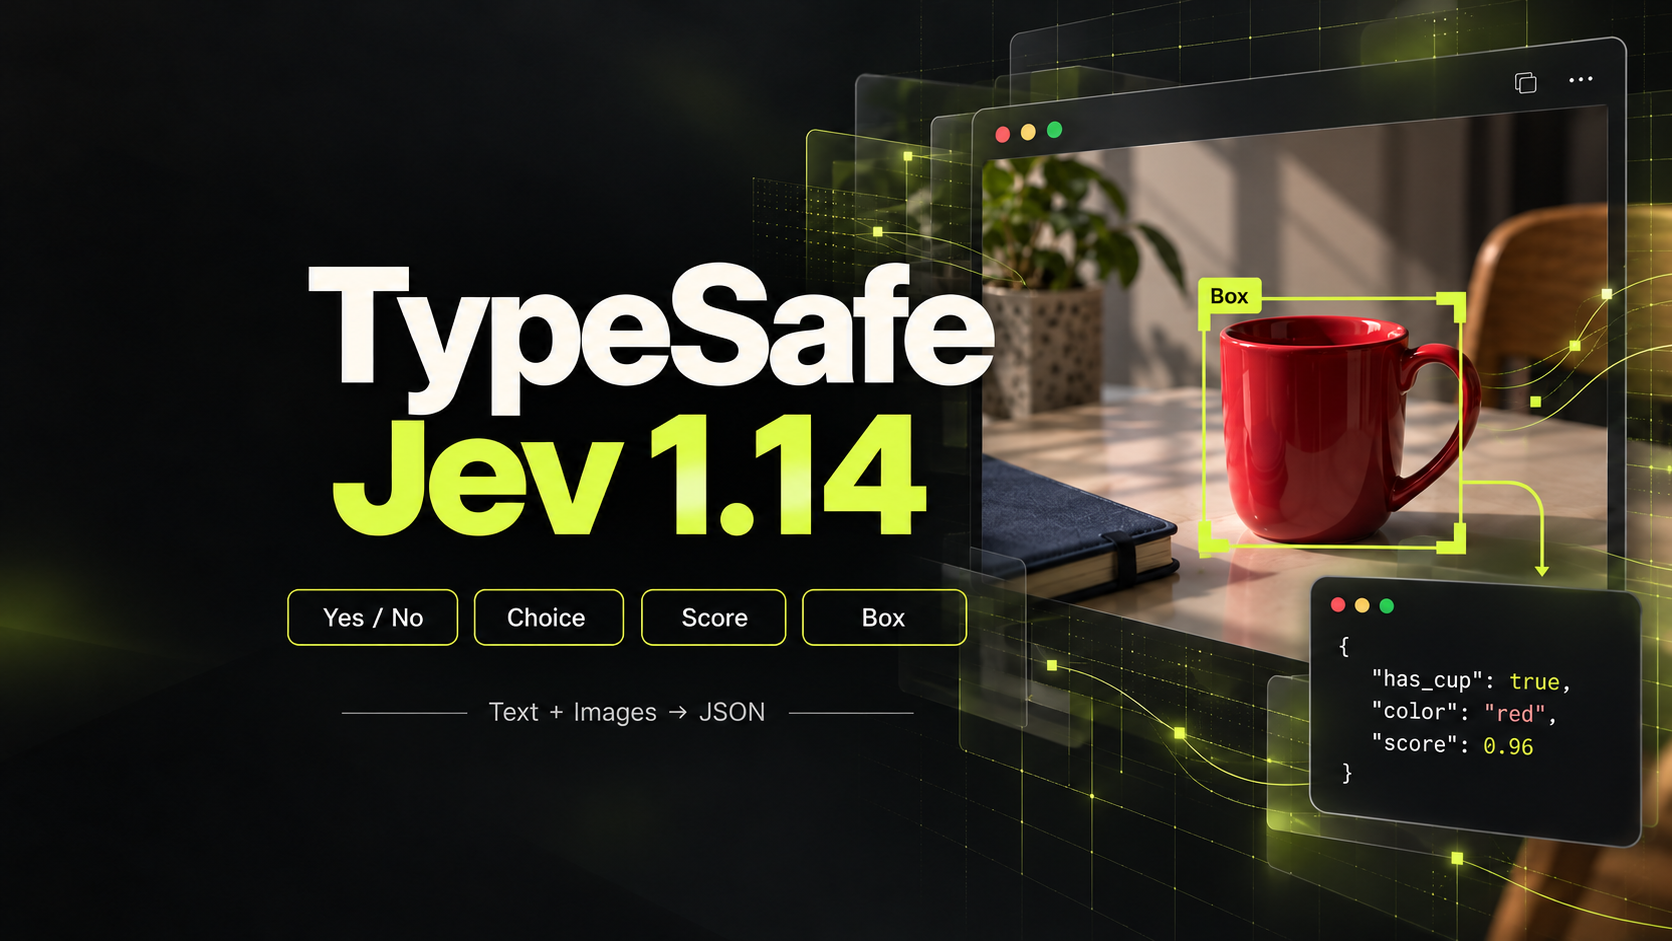
 TypeSafe
 Jev 1.14
Structured multimodal decisions from text, JSON, and inline images.
Explorez la génération vidéo IA avec audio pour vos scènes
FOURNISSEURS
 Black Forest Labs
 Kling
 Lightricks
 OpenAI
 Runway
 SeeAPI








Chronologie des sorties de modèles
Vidu Q4
ViduVidu Q4 preview video generation with image or multi-reference guidance, audio, up to 16 seconds, and up to 4K output.
Wan 3.0 Prime
AlibabaGénération vidéo Alibaba Wan 3.0 Prime avec références de texte, d'image, de vidéo, d'audio, de document et de page web.
Wan 3.0
AlibabaGénération vidéo Alibaba Wan 3.0 avec références de texte, d'image, de vidéo, d'audio, de document et de page web.
Gemini Omni Flash 1.1
GoogleGemini Omni Flash 1.1 video generation with image, video, audio, and character references.
Seedance 2.5
ByteDanceModèle vidéo nouvelle génération de ByteDance pour les récits longs, avec jusqu'à 50 références multimodales
MiniMax H3
MiniMaxGénération vidéo multimodale avec audio natif via MiniMax H3 (Hailuo 03), jusqu’en 2K.
Seedance 2.0 Mini
ByteDanceModèle vidéo Seedance 2.0 économique de ByteDance, conçu pour une génération plus rapide et des coûts d'inférence réduits
Seedance 2.0 Fast
ByteDanceVidéo multimodale rapide et abordable avec entrées texte, image, vidéo et audio jusqu'à 720p
Grok Imagine Video 1.5
GrokGénération image vers vidéo avec xAI Grok Imagine Video 1.5
Wan 2.7
AlibabaL'API vidéo Wan 2.7 d'Alibaba prend en charge les entrées multimodales complètes (texte, image, vidéo, audio) pour quatre modes (T2V, I2V, Reference2V, Edit), avec des sorties en 720P–1080P.
Concevez image et son ensemble
Cette catégorie réunit des modèles vidéo ayant une capacité audio.
Décrivez ce qui doit être entendu
Reliez le son aux événements visibles et distinguez dialogue et ambiance.
Comparez l’audio par endpoint
Interrupteurs, langues, audio de référence et comportement de la bande sonore varient.
Évaluez l’ensemble audiovisuel
Un bon extrait associe un son cohérent à l’action et des images continues.
Préparez un test audiovisuel
Transformez vos exigences en requête compatible avec la documentation publiée.
Écrivez un brief attentif au son
Indiquez scène, action principale et sons associés.
Vérifiez les réglages audio
Contrôlez mode d’entrée, options et prix avant l’envoi.
Regardez et écoutez
Examinez timing, dialogue et continuité, en conservant la configuration.
Génération vidéo IA avec audio : questions fréquentes
Clarifiez le flux avant de choisir un modèle.
Le son est produit dans la capacité de génération vidéo du modèle, plutôt qu’ajouté ensuite dans un éditeur.